
复制一组Meta标签到网站head很容易,难的是它与主题、SEO插件原来生成的内容保持一致。一个页面如果出现两个标题来源、多个相互矛盾的canonical,新增标签不一定解决问题,反而可能让维护更复杂。
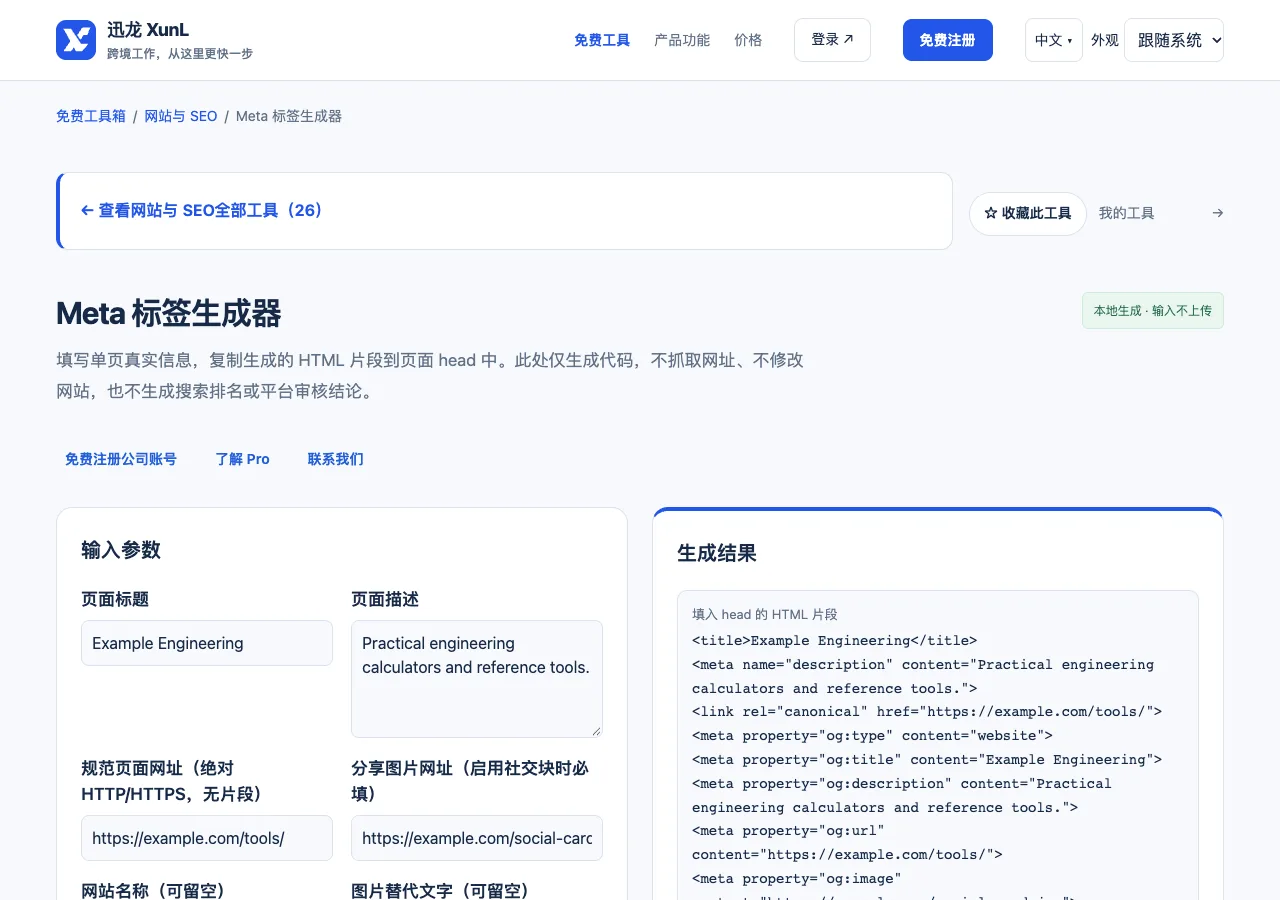
先填写这一个页面真正表达的内容
XunL Meta标签生成器接受页面标题、描述、规范网址和分享图等资料。以“产品安装指南”为教学标题,描述写实际步骤与适用范围,规范网址填写最终公开HTTP或HTTPS地址,不使用带片段或预览令牌的链接。
标题和描述应与正文一致,不在标签里补造免费、价格或认证。网站名称可以按真实品牌填写,分享图也应对应当前页面,而不是随意借用不相关大图。
转义是正确输出,不要手工解回去
输入中含与号、尖括号或引号时,工具会按HTML语境转成实体,描述换行也会整理为空格。看到代码里出现转义形式,不代表标题文字被改变,浏览器解析后有对应显示含义。
不要为了让源码“看起来像原文”把实体全部替换回特殊字符,可能破坏属性或标签结构。也不要将生成结果再次当普通文本转义后贴入模板,否则公开页面可能显示代码而不是正确元数据。
Robots和社交块按需要明确选择
默认省略robots,避免无意改变现有索引策略。若确实需要限制索引,要先确认页面用途及HTTP头、其他标签的组合,不把noindex当作访问权限。robots文件的禁止抓取与页面不索引也不是同一个设置。
可选Open Graph使用当前页面提供的网站类型,Twitter或X卡片也按支持项生成。工具不是任意结构化元数据编辑器;文章日期、作者与BlogPosting等需求,应使用相应功能或网站模板,不假定勾选website就包含全部文章信息。
部署时只替换负责的部分,再读回
多语言页面还要分别使用对应正文与规范地址,不能把中文页标签直接复制给英文页只换标题。分享图片中的语言也应检查,避免链接正确却展示了另一市场资料。
先检查网站是否已有主题或插件管理这些字段。确定单一来源后,在对应页面配置或受控模板中处理,不直接覆盖完整head,避免删除视口、样式、验证和其他必要内容。
发布后从正式地址检查源码,核对标题、描述、canonical是否各为预期,分享图是否可取得,并确认没有残留另一份矛盾输出。缓存存在时,后台保存成功不代表公开结果已经更新。
这一步不保证搜索系统原样展示标题与摘要,也不承诺排名。页面技术验收、内容质量与实际索引表现需要分开观察。生成器整理代码,不替你证明目标页正常或分享图清晰。
为什么不生成meta keywords?
不要把关键词堆砌当作页面主题表达。应优先写清标题、描述和正文,并维护正确规范关系;本工具按明确白名单输出,不是任意标签大全。
图片地址存在,社交平台一定显示吗?
还要看公开访问、格式、尺寸与平台缓存。生成标签只是声明,真实分享效果需要在实际环境继续核对。
个人微信:ssevening


