
整理商品清单时,A-01、a-01和带首尾空格的A-01是否算同一个SKU?答案取决于业务编码规则,而不是工具默认设置。去重前不定口径,可能把本来不同的型号误删,也可能留下应该合并的脏数据。
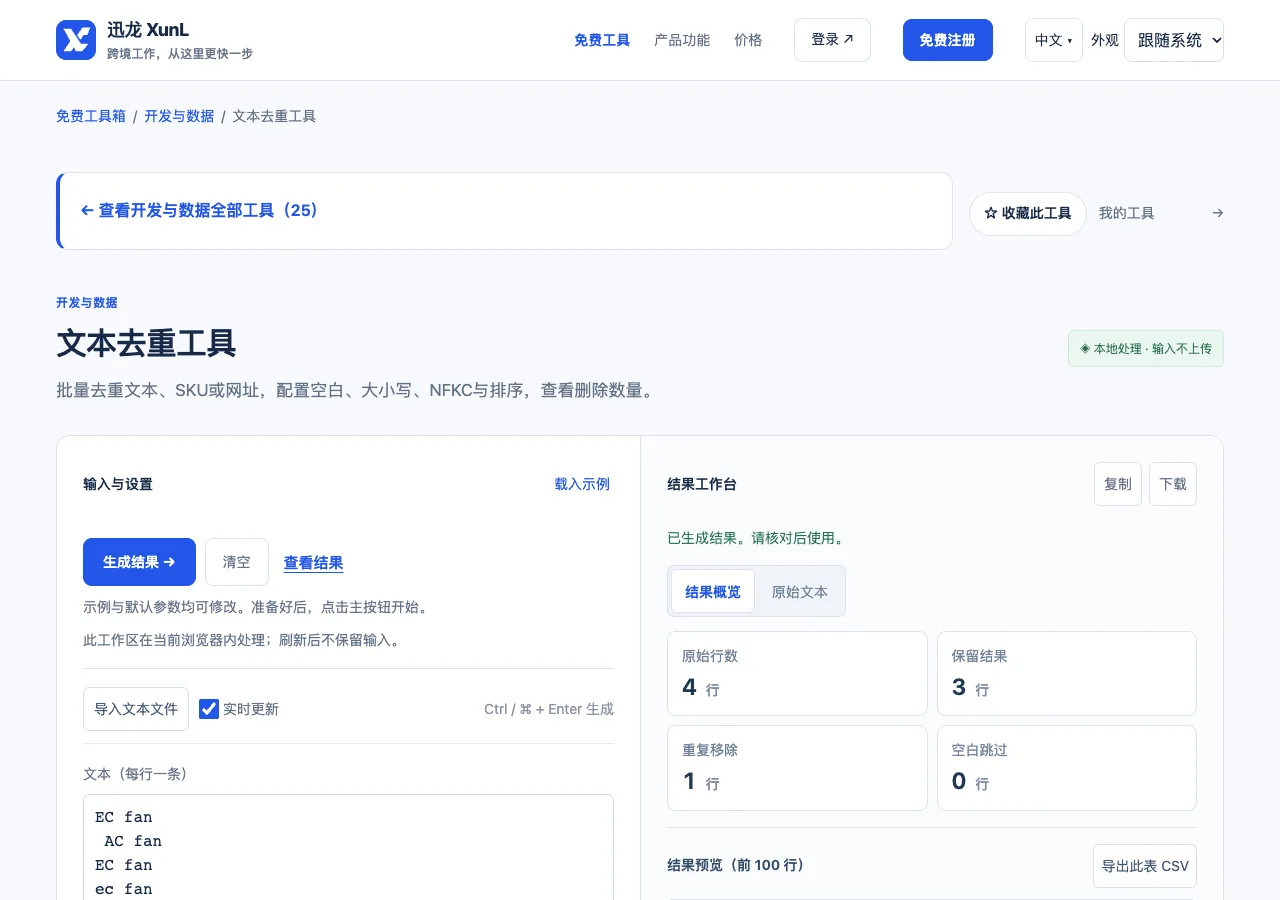
先用四行小样本说明比较规则
在XunL 文本去重工具中,每行放一条记录。可以输入“EC fan”“ AC fan ”“EC fan”“ec fan”,先用精确比较和保留空白,再逐项切换设置,观察哪些行被分到同一组。
不要同时打开所有清洗选项后只看结果变少。先确认大小写是否有含义,再决定是否去首尾空白;每改一项都看保留和删除的差异,才能知道减少的原因。
NFKC有用,但不是所有编码都适用
全角与兼容字符可能来自复制粘贴,NFKC可以在比较时将部分形式归为同组。对于普通名单清理很方便,但SKU、法律编号或其他严格标识应先核对编码规范,不能假定视觉接近就业务等价。
工具保留首次出现的代表文本,比较时规范化不等于输出会改成你心中最标准的版本。如果需要统一展示格式,应另定清洗规则,并保留原始值与标准值的映射,不要把去重与改名混成一步。
排序与空行,影响后续怎样使用
默认可保留首次出现顺序,也可以按需要排序。若原清单顺序代表优先级或来源时间,不要为了整齐升序后丢掉含义。空行则可以去掉或保留一个,选择应与后续导入要求一致。
复制输出以前,记录原始行数、删除数量和处理设置。数量减少不是唯一目标,关键是每个保留项有合理代表。批量导入前抽查容易混淆的型号、中文空格和前导零,避免仅核对总数。
如果输入一行同时包含型号和数量,去重依据就是整行,不会自动理解哪一列是SKU。想按型号合并数量,需要表格或专门聚合步骤;把重复行直接删除,可能丢失不同批次需求。先确定一条记录代表什么,再选处理方法,尤其不要把去重结果误当成已合并采购数量的清单。
网址与邮箱去重,还需要额外判断
两个URL即使指向同一内容,文本可能不同;同一个网址的不同参数,也可能表达不同状态。工具按字符串规则比较,不会访问目标页面或判断canonical,因此不能自动完成内容级合并。
邮箱与商品同理,去重不会验证真实存在、归属或是否还能使用,也不理解“离心风机”和“centrifugal fan”是否同义。需要语义或业务校验时,应单独安排,不把文本整理说成数据真实性审核。
实际工作可以先用脱敏样本确认规则,再处理整批,保存原清单和结果。若输出要交给同事,附一句明确口径,例如“忽略大小写、去首尾空白、保留首次顺序”,后面的人才能解释为何某行被合并。
为什么结果没变成统一大写?
忽略大小写用于比较,不等同于把代表文本全部改写。若需要统一大写,应另做明确转换,并确认不会破坏编码含义。
重复清单能否直接覆盖原文件?
先保留原件和设置,抽查合并结果再使用。错误口径造成的误删,仅靠已经去重的输出未必能恢复原来源与顺序。
个人微信:ssevening


