
A版本转化率三点二,B版本三点八,看起来后者更好。但测试可能还没达到计划样本,也可能两组流量并非随机均衡。先验证数据与实验设计,再讨论胜负,比看到一个上升百分比就上线更可靠。
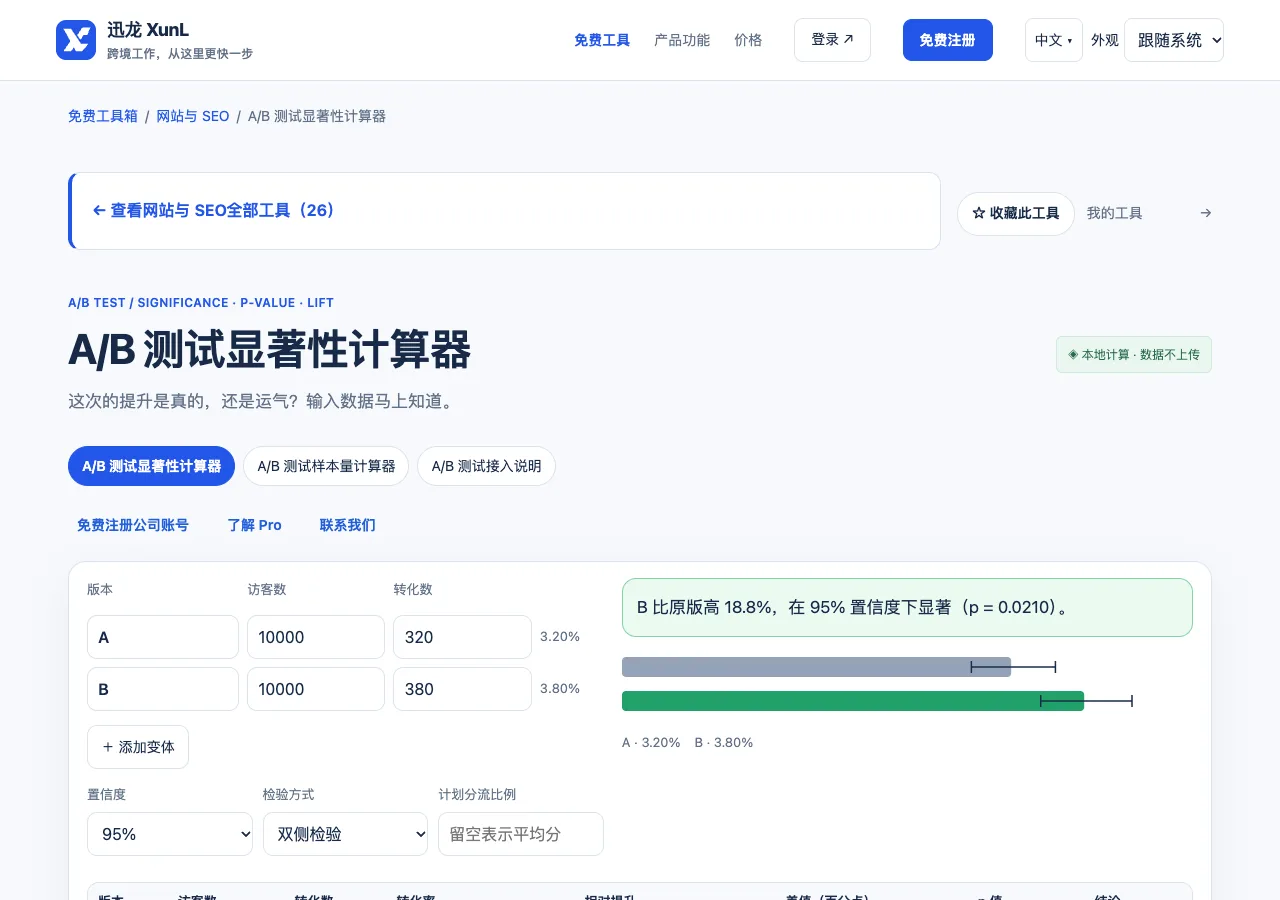
先用一组可手算的数据检查口径
在XunL A/B测试显著性计算器填写假设数据:A有一万访客、三百二十次转化,B有一万访客、三百八十次转化。两组转化率分别为百分之三点二和百分之三点八,相差零点六个百分点,相对提升为百分之十八点七五。
这些算术不等于已经获得显著结论。p值与差值置信区间应由所选统计设置计算,不能仅凭B多了六十次转化推断。输入前还要统一访客和转化定义,确认两组覆盖同一时段与同一目标。
p值不是“B胜出的概率”
p值描述在无差异假设下,观察到当前或更极端数据的相容程度,不能直接读成B比A好的概率。差值区间则帮助理解效果的不确定范围,区间宽时,即使点估计不错,仍可能缺乏稳定判断。
选择置信度与单侧、双侧方式应在看结果前确定。双侧允许关注变好或变差;不能看完数据觉得不显著,再换成更容易得到期望结论的方式。工具算得出数字,不代表事后改变设计也仍可按原计划解释。
先检查分流,再看转化提升
计划平均分流,实际样本比例却明显偏离,需要看SRM提示。跳转、脚本、过滤或记录方式可能使两组人群不再可比。出现分流质量问题时,应先排查数据,而不是忽略提示继续宣传提升。
多个变体同时与原版比较,会增加偶然发现差异的机会。工具采用Holm校正处理多重比较,校正后的证据要求与单个比较不同。不能从很多版本里只挑表现最好的一个,再假装从头到尾只测试这一对。
转化数也应符合指标设计。如果同一访客可以产生多次动作,应先确认输入所用方法是否适合该统计口径,不把点击次数随意当作转化访客数。实验前就定清楚分母与分子,后续解释才不会变动。
显著以后,仍要回到业务价值
还应检查同一访客是否稳定分到同一版本,以及各组是否同时经历相同活动与渠道变化。若一组主要来自广告、另一组主要来自老客户,即使数字差异明显,也不能轻易解释成页面改动造成。
上线还要考虑提升是否足以覆盖维护成本,是否损害订单质量、性能或其他重要指标。短期按钮点击增加,不必然意味着成交或利润增加。主指标之外可以设护栏,但不能在结果出现后随意换一个更好看的指标宣布成功。
按事先计划样本和周期运行,避免每天看一次结果,刚好显著就停。工作日和周末人群可能不同,流量来源也可能变化。保存计划、实际时间与异常事件,可以帮助后来的人判断结果是否可靠。
显示不显著,代表两个版本完全一样吗?
不代表。可能效果很小,也可能样本不足或波动较大。应结合区间和原计划判断能排除哪些差异,而不是把没有证据当成证明没有差异。
显著但提升很小,是否必须上线?
不必。统计证据与业务收益是两个问题。若收益不足以覆盖实现成本或引入额外风险,可以保留原版,并据此规划更有价值的后续假设。
个人微信:ssevening


