
一条查询把多张表、子查询和CASE都挤在一行,看到结果异常也难以定位。格式化首先解决阅读问题,让表关系、筛选和聚合显露出来;它不是自动优化器,也不应该替代数据库测试。
先确认真实数据库方言
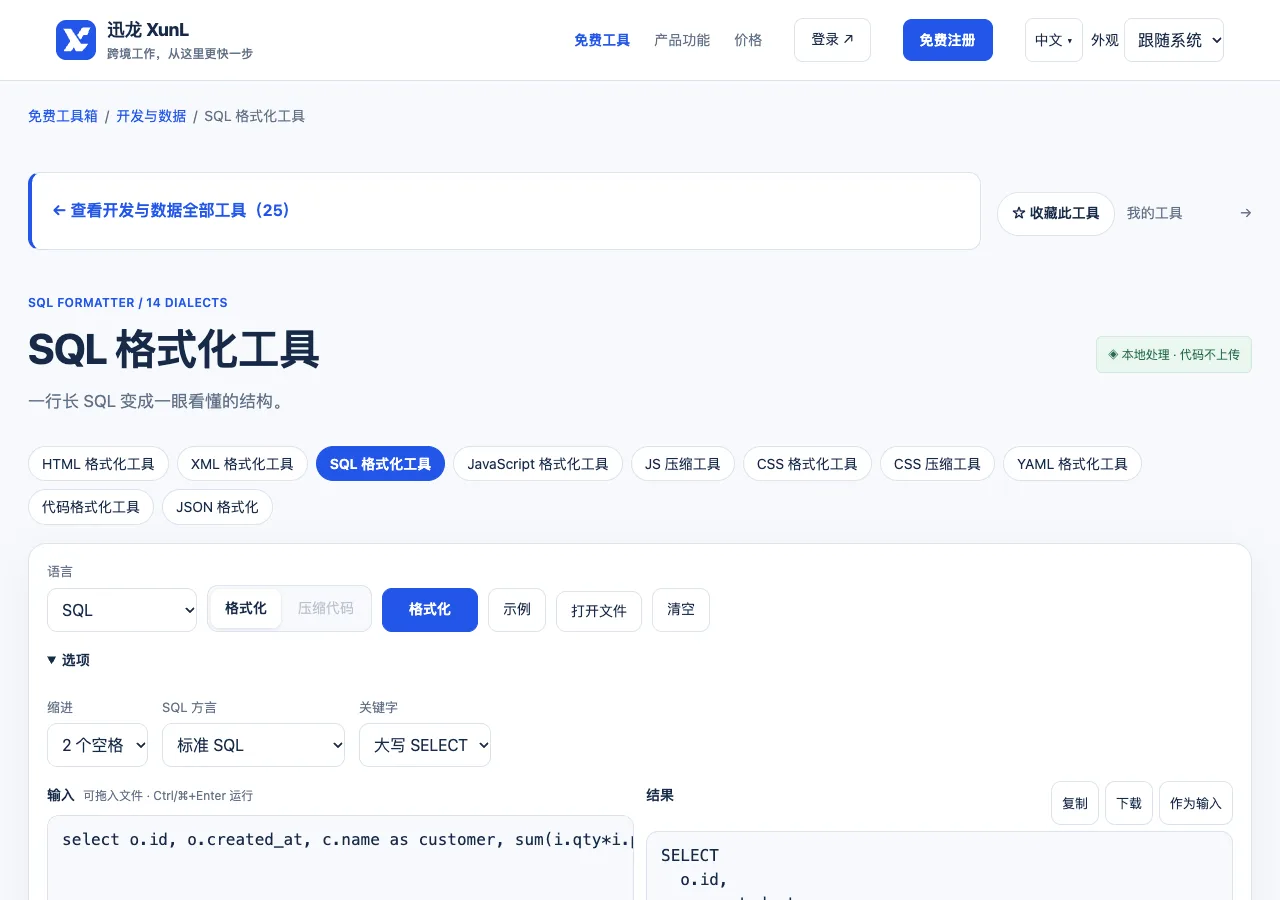
在XunL SQL格式化工具里选择SQL及对应方言,再粘贴查询。MySQL反引号、SQL Server方括号和PostgreSQL类型转换等写法存在差异,自动识别或错误方言可能导致解析失败。
例如教学查询可以写 select customer_id,count(*) as orders from orders where status='paid' group by customer_id;。格式化后将SELECT、FROM、WHERE与GROUP BY展开,先看每个子句负责什么,再处理真实项目里的多表关系。
排版以后,按数据流逐段阅读
先确定FROM从哪些数据开始,JOIN如何匹配,再看WHERE排除了什么,最后检查分组和输出。连接条件与业务筛选应清楚区分,别名也要让团队能理解,不要在同一长查询中反复换成难记字母。
假设订单连接明细后行数增加,应核实是一对多关系正常展开,还是连接条件漏了。格式化让问题更容易看见,却不会替你判断一行代表订单还是商品。聚合结果是否正确,要回到测试数据与业务口径。
对外连接也要留意条件位置。排版工具不会自动纠正WHERE筛选造成的行为变化,不能为了看起来统一把条件随意搬动。字符串、引号标识符与参数占位符也应保持原意,不进行无根据的批量替换。
纯格式提交与逻辑修改分开
先把团队风格统一为一致缩进和关键字规则,再单独修改查询逻辑,审查差异会更聚焦。如果同时重排几百行并改掉过滤条件,同行很难发现真正影响结果的那一行。
保留格式前文本与设置。工具在浏览器处理代码,但其中若带有客户数据或凭证,仍应先脱敏,并检查复制出的内容是否适合进入工单或公开聊天。格式化不是数据清洗和权限审查。
正确性、性能与执行权限,另行验证
在测试库对照代表数据运行查询,比较行数、关键字段、空值和聚合结果。性能问题要结合执行计划、索引、数据分布与实际耗时,不能把SQL变得整齐就称为加速。
本工具不会连接数据库,也不会替你确认更新或删除语句影响范围。处理变更语句时仍按既有发布规范备份和验收,不能因为格式化成功就直接在生产执行。查询语法可读只是开始,不是执行授权。
多人协作时,可以为复杂查询附口径说明:输入表、输出粒度、时间范围和去重规则。这样后来的人修改JOIN或分组时,知道哪些结果不能变,不会只根据排版猜原作者意图。
格式化会把慢查询变快吗?
不会自动改善执行计划。它帮助看清结构,真正优化仍需证据和测试,避免在没有数据支持时随意改写等价关系。
为什么语句在工具里可读,数据库仍报错?
可能与方言、数据库版本、表结构或权限有关。应检查真实错误与目标环境,不能把排版能力当成完整数据库语义验证。
个人微信:ssevening


