
同事发来一段没有扩展名的代码,花括号可能属于JSON,也可能属于JavaScript或CSS。自动识别适合减少点击,不能替你判断所有上下文。开始处理前先问这段代码从哪里来、准备回到哪个系统使用。
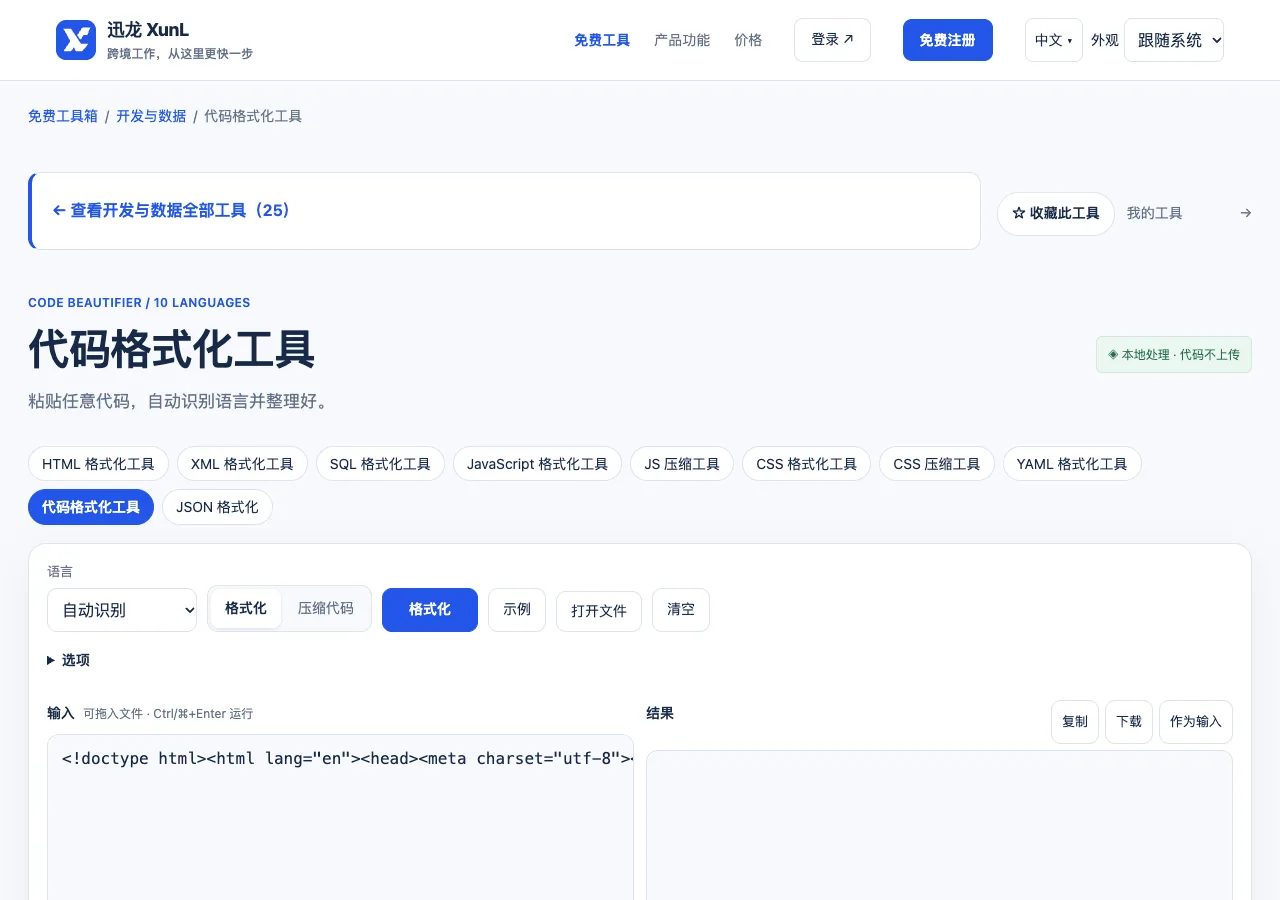
用内容和来源共同判断语言
XunL 代码格式化工具覆盖HTML、XML、CSS、JavaScript、JSON、YAML和SQL等页面列出的语言。粘贴后查看选择是否符合实际,片段太短时直接手动选择,不必通过反复增删字符迎合识别。
例如 {"sku":"A-01","qty":2} 可以作为JSON解析;如果变成未加引号键名或包含函数,就不再是严格JSON。对象看起来相似不代表语言相同,错误语言可能产生误导性报错。
美化和压缩,先决定哪一种任务
需要阅读与审查,选择格式化并统一缩进和行宽;需要发布产物,再选适用压缩。两者用途不同,不要将压缩输出作为唯一维护源。引号、分号与尾随逗号等设置也应遵从团队约定。
混合模板要特别谨慎。HTML中可能包含服务端占位符,CSS可能是预处理源码,脚本可能含构建工具专用语法。工具无法补全缺失上下文,遇到报错应先确认输入是否完整、语言是否正确,而不是删掉不认识的部分。
行列提示帮助定位,不负责猜原意
报错位置可以指示解析停止的地方,真正原因可能出现在更早的括号、引号或结构。先缩小到最小有效片段,再逐步加回内容,比一次改动整份文件更容易找到原因。
格式化可以展示层级,却不能替代运行验证。SQL仍需要目标方言与数据库,TypeScript仍要编译,YAML仍有应用字段要求,HTML和CSS还需要真实渲染。不要因为一种语言能美化,就推导成所有业务条件都正确。
临时整理与长期规范,各有合适做法
偶尔收到一份压缩代码,可以用格式化副本辅助阅读,保留原文便于比较。项目长期维护则最好把设置纳入仓库与构建链,避免每个人手工选择不同风格,产生无意义差异。
纯排版修改单独提交,再做逻辑变更,审查会更聚焦。对多语言文件,一次只整理一种类型并抽查代表样本,不把整套代码交给自动识别后直接批量覆盖。
引擎在浏览器本地处理代码,但资料权限仍需遵守。粘贴前脱敏凭证、客户数据与不应外传的内容;下载结果也要有版本标识,不能把示例与生产文件混在一起。
最终输出应在目标环境检查,保留处理前后文件和必要测试记录。格式化不是反编译,删除的注释和原变量名无法凭空恢复;它也不是安全清洗器,未知代码不因排版成功就值得执行。
自动识别错了,是否说明代码损坏?
不一定,短片段往往缺乏特征。先手动选正确语言,再核对来源和完整性,避免把工具选择错误当成业务文件错误。
压缩代码美化后,能当原始源码用吗?
可以辅助理解,但丢失的名称、注释与构建信息仍然缺失。正式修改优先回到源码和映射,避免在临时副本上形成无法复现的新版本。
个人微信:ssevening


