
客户评论中“噪音”出现很多次,是否就该优先做静音产品?还要看原句是在抱怨噪音,还是说没有噪音,也要看这些评论来自多少客户。词频能帮助找到值得阅读的线索,不能自动回答完整经营问题。
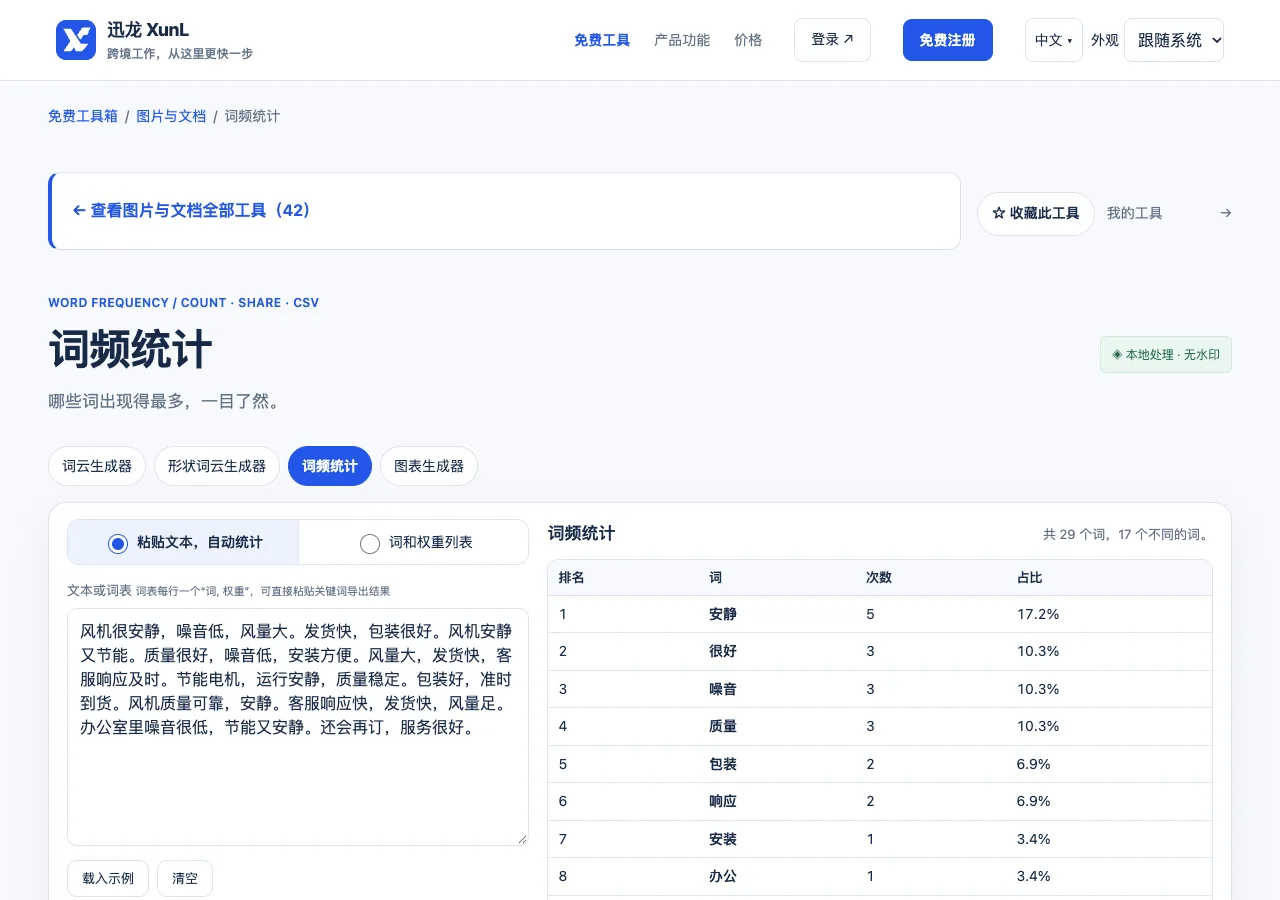
先确定文本范围与重复来源
把脱敏评论或询盘内容放入XunL 词频统计。可以用“安装方便,声音较轻。安装说明清楚,接口需要确认。”作为教学小样本,观察中文分词后哪些词被保留,再与原句对照。
正式分析先排除重复采集、模板签名和大段页脚。相同邮件转发多次会人为增加词频,不能把它当作多个客户独立提出。保留原文编号与来源时间,后续才能回查具体表达。
停用词和最短词长,都会改变结果
常用虚词可以过滤,也可按任务关闭。品牌名、公司名或模板词可以加入排除项,但应记录设置;否则两次报告用了不同规则,次数和占比不能直接比较。
最短词长过高可能漏掉重要短词,过低则可能增加噪声。中文自动分词也不一定理解所有行业术语,遇到型号、材料或专有名词应抽查。不要看到一个完整术语被拆开,就直接把两部分当成两个独立需求。
英文可启用两词词组,例如centrifugal fan,帮助保留组合含义。但词组与单词统计不是互斥分类,不能把它们的占比相加解释成用户构成。
次数与占比,先说清分母
占比按有效词总数计算,不是“多少客户提到”。假设清洗后有效词共一百次,某词出现十次,词次占比是百分之十;若其中十次来自同一条长评论,也不能说百分之十客户有该诉求。
否定、比较和上下文尤其重要。“不需要加热”包含加热,却不是希望增加功能。建议先选高频词,再回到对应原句人工归类,区分肯定、问题与无关出现。统计用于加快阅读,不替代理解。
导出以后,给结论补上证据
下载CSV可保留排名、词、次数和占比,再添加样本说明、排除规则与原句引用。若报告要比较不同时期,统一文本来源、长度差异与处理设置,不把一次数据量增加误写成某需求增长。
词云可用于概览,精确比较仍应附表或条形图。图中词大只是视觉强调,不自动代表情绪强度、购买意愿或市场容量。客户资料在分享之前继续脱敏,不把原始姓名和联系方式混进公开图形。
确定选题或产品动作前,还要结合样本代表性与真实业务数据。论坛评论、老客户邮件和销售记录反映不同群体,不能因为合并文本方便就把它们当作同一个总体。
为什么换个排除词,占比全变了?
排除项会改变有效词总数,分母变化后其他词占比也可能改变。比较报告时应保留规则,不只截图排名前十。
某词出现最多,就应该写成文章主关键词吗?
不一定。还要判断搜索意图、用户原句与内容目标。高频可能来自品牌模板或否定表达,需要结合真实问题再决定。
个人微信:ssevening


