
报告列出一千条问题链接,不应该立刻全部删除。404、403、429和超时可能对应完全不同情况,外部社交页面尤其可能拒绝自动程序。先分类,再定位引用页,才能避免误删正常入口。
从一个小范围验证设置
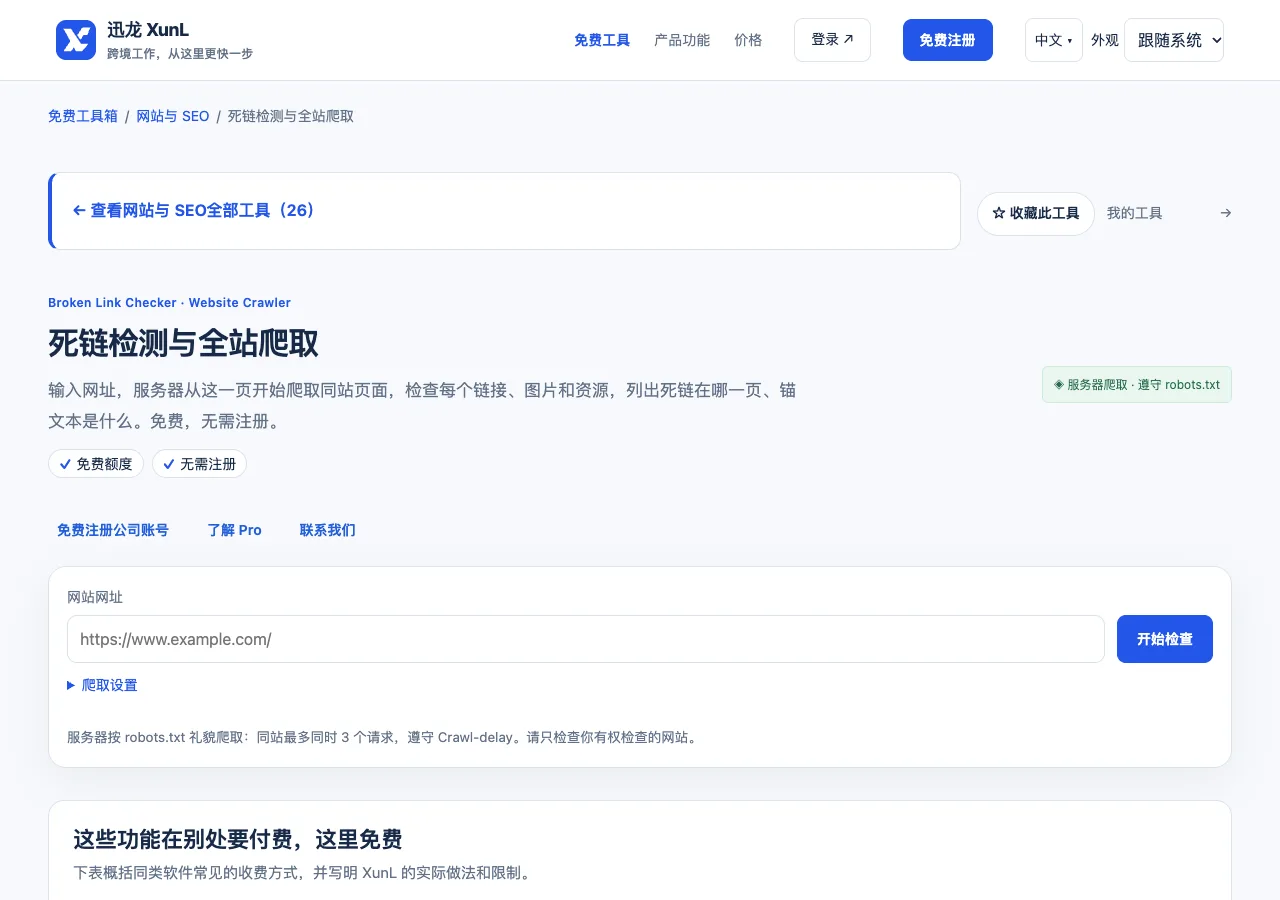
在XunL 死链检测与全站爬取输入自己维护的公开网站,先选择适合的深度和网址上限。小站可先用较小范围理解结果,再扩大,外部链接、图片与CSS或JS资源按验收目标勾选。
读取Sitemap可以补充公开页面,但不代表已涵盖所有历史内容。爬取遵守robots规则,登录、操作性入口与达到边界的地址会受到相应限制。任务结束先看覆盖与跳过情况,再解释发现数量。
找到问题,也要找到是谁引用它
例如某张产品图404,应记录目标图片与引用页面,查是文件丢失还是路径写错。只修一个已打开的页面,却让其他文章继续引用旧地址,问题仍会重复出现。
页面链接同样保留锚文本与来源。若旧产品已有等价新页,可以按迁移策略改引用和跳转;若没有替代内容,不能随意跳首页假装修复。要让用户到达与原意相符的内容,而不是仅改变最后状态。
被拒绝与暂时失败,先复核再行动
401或403可能要求身份或触发防护,429涉及频率,部分外部网站还有特殊拒绝响应。浏览器可正常访问的情况应单独记录,不直接叫永久死链。超时和5xx也可能是临时故障,结合时间和目标日志确认。
重复重试不一定改善证据,反而可能加重限制。先检查工具提示、服务状态和实际用户路径,再安排适度复查。明确删除、替换或保留的依据,避免仅为让报告数字变少处理。
导出结果,建立修复与复查对应
按页面、资源、外链与状态筛选,导出Excel用于分工。每条至少附来源、目标、原状态、处理方式与复查结果。修复后重新检查相同范围,并抽查其他受同一模板影响的页面。
工具只读取服务器返回的HTML,不执行JavaScript,动态生成链接可能未被发现。未爬到、被规则跳过与没有错误不是同一状态,报告应保留这些边界。
可据本次符合条件的页面生成地图,仍需上传前核对。它不会自动替你证明全部内容应被索引,也不会包含所有没发现的页面。地图清单与死链报告是相互补充的资料,不是同一个完成标准。
重要任务及时保存结果,别依赖临时页面长期可用。爬取公开资料也应控制范围与运行节奏,自己的站点可以结合后台深度诊断或日志继续补充,避免为追求数量反复运行相同扫描。
修到全部绿,就能说明全站健康吗?
只能说明本次覆盖内的对应观察,动态功能、权限流程与未发现内容仍需另外验收。不要把受限检查扩大成全站保证。
外链被拒绝,应该直接删掉吗?
先人工核对目标与业务必要性。若用户可正常取得可信资料,可保留并注明检测条件;若实际内容已失效,再选择合适替代。
个人微信:ssevening


