
准备重做网站,开发问“旧网址有多少”,运营只找到一个sitemap.xml。打开后却不是文章列表,而是一组子地图地址。如果只复制最外层内容,就会漏掉真正需要迁移的页面;如果把每份子地图数量直接相加,又可能重复计算相同网址。
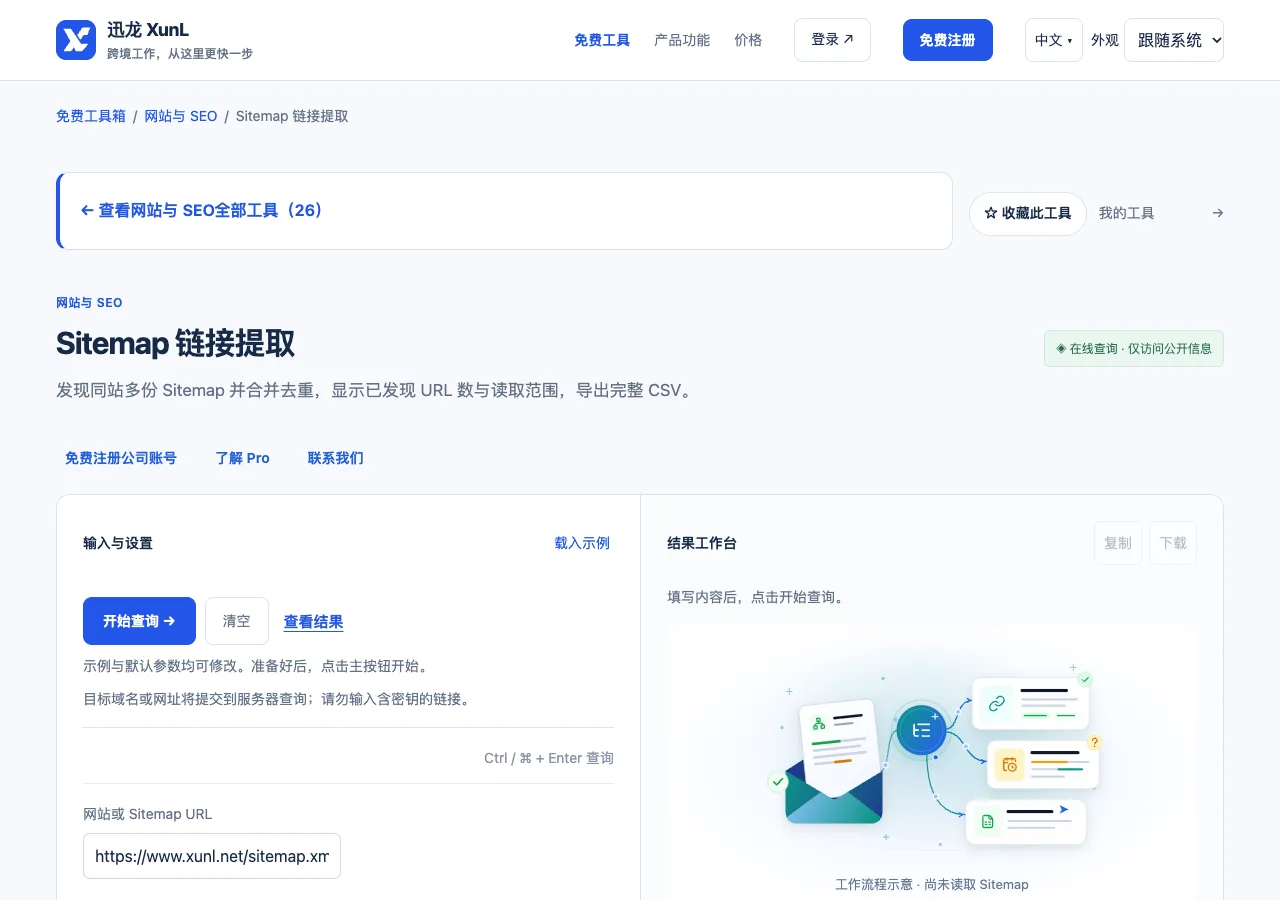
输入网站,或从已知地图开始
XunL Sitemap链接提取可以发现同站多份地图并整理去重。已知地图地址时直接填写,例如本站实际公开的 https://www.ssevening.com/wp-sitemap.xml;不知道地图入口时,可以先提供网站地址,再查看发现了哪些来源。
提交以后,先阅读读取范围和状态,而不是直接抄汇总数字。工具会有界展开索引与子文件,失败、超时或触及处理限制时可能保留部分清单。此时正确表述是“本次成功读取的范围”,不是“已经数完网站所有页面”。
去重以后,来源仍然要留下
设想产品地图与文章地图误收了同一地址。汇总数量经过URL去重后,可能小于两份文件行数相加。去重是为了得到清楚清单,来源地图则能帮助追查配置为何重复;二者不应只保留其一。
下载完整CSV后,可以在表格中增加“页面类型”“是否保留”“新地址”“当前状态”和“负责人”等列。原始网址列暂时保持不动,另建清洗列处理协议、参数或尾斜杠。这样发现过度合并时仍可回到原数据,而不是丢失原始入口。
不要把看起来相似的地址立即视为同一内容。查询参数可能只是跟踪,也可能改变分页或产品选项;是否合并,应结合规范网址与页面用途。提取阶段保存实际声明,迁移阶段再应用明确规则,能减少误伤。
日期和数量,不足以证明内容状态
地图中的lastmod由网站声明,可能为空、过时或集中更新。大量地址同一天修改,可能是模板或生成器更新,不必然说明当天发布了同样数量的新文章。若要研究发布历史,需要额外的页面和历史记录。
同样,地图列有某个网址,不证明它返回正常内容、允许索引或已被搜索引擎收录。清单中可能有跳转、错误页或无意加入的标签页。应按项目目标抽查状态与内容,尤其关注主要流量入口与旧外链目标。
把地图清单放进完整迁移工作里
地图之外,还可能存在未列出的旧文章、参数入口和历史活动页。可以结合后台导出、分析数据和访问日志补充,再为重要页面建立旧新映射。不能因为某条旧链接不在地图里,就直接判定没有用户或不需要处理。
迁移完成后,仍从旧入口核对跳转和最终内容。新的地图应列出当前希望公开的规范页面,内部导航也应直接使用新地址。把旧清单、映射与复查结果保留在同一份工作簿,后续调整就有持续可用的依据。
CSV比页面展示多,应该以哪一个为准?
先看页面是否只显示预览片段,以及导出说明覆盖哪些成功读取结果。用于盘点时保留完整下载文件,并记录该次读取状态,不用可视区域的行数代替完整数据量。
提取结果可以直接用来生成新地图吗?
先清点和验证。应该剔除不再存在、不希望索引和非规范的入口,再决定新地图包含什么。机械复制旧清单,可能把旧站的问题一并迁过去。
个人微信:ssevening


