
网站根目录有robots.txt,开发说配置没问题,运营却发现产品页似乎被限制。与其逐行猜,不如带着具体路径和身份去匹配。规则的含义取决于适用组与路径,文件存在只能说明找到了入口。
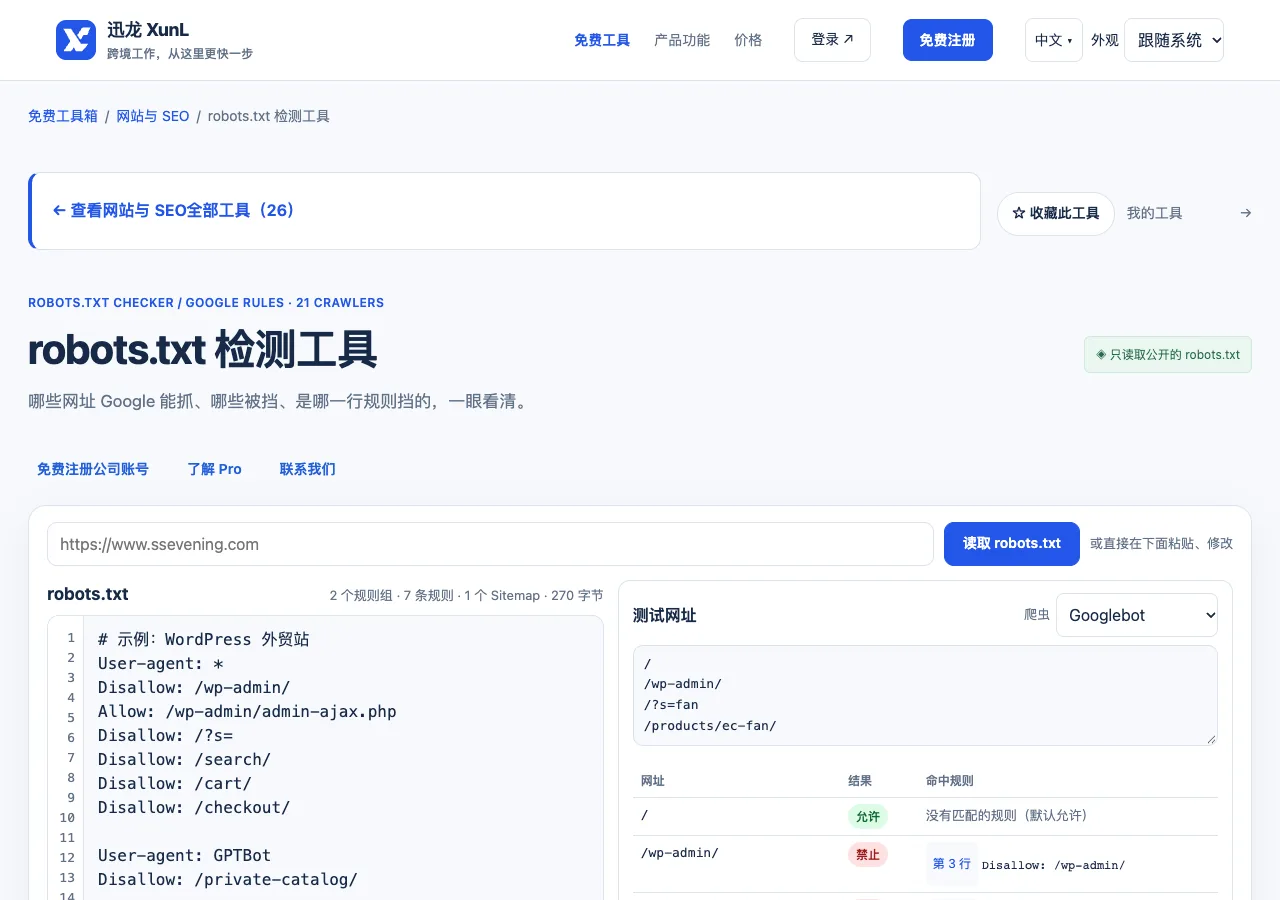
先确认测试的是线上版本还是草稿
XunL robots.txt检测工具可以读取网站根目录公开文件,也可以直接粘贴尚未部署的规则。读取前填写正确协议与主机,例如https与http、www与子域名不能随意混用,它们不共享同一份适用范围。
如果改规则前先粘贴草稿,应在记录里注明这是待发布版本。测试通过以后仍要上线并读回实际文件,否则很容易把本地草稿的结论误认为线上状态。
用四条路径覆盖不同意图
可以从首页、一个产品详情、站内搜索和后台目录开始,例如 /、/products/ec-fan/、/?s=fan、/wp-admin/。这些只是示意路径,要换成本站真实结构。选择Googlebot等目标身份,查看各路径允许或禁止及对应命中行。
同一规则可能意外覆盖公开资料。例如下载目录里既有面向客户的说明书,也有内部文件,简单封掉整个目录未必符合目标。内部文件应有真实权限控制,公开说明书则要按业务策略处理,不能靠一条宽泛规则兼顾所有需求。
更具体的身份组与通用组、允许和禁止之间存在匹配优先级。不要只看第一条Disallow就结束,应通过结果定位实际采用的规则,再回到完整文件理解上下文。
脚本和样式,也应进入样本
公开页面需要某些资源才能呈现内容时,应检查这些资源是否被限制。尤其是传统主题或插件目录,机械禁止大范围公共资源,可能影响渲染观察。先确认资源用途,再决定规则,不能将“看起来不是正文”当作一律禁止的理由。
需要读取地图时,也应检查文件中声明的Sitemap是否真实可取。规则测试本身主要在浏览器按匹配逻辑计算;只有主动选择真实访问等功能时,才是对具体页面发起访问,两类结果要分开记录。
模拟匹配与真实平台为什么可能不同
工具按相关公开规则模拟,不是Google官方解析器或真实抓取记录。平台可能缓存旧文件,网站也可能按来源或频率返回不同响应。因此与Search Console不同,应先核对版本、身份、时间与访问条件,不直接判定某一方错误。
允许抓取不代表已经收录,禁止抓取也不是安全保护或可靠的移除搜索方法。若目标是限制索引,应采用相应页面或HTTP指令并确保平台能读取;若是私密数据,应使用登录与权限。
发布前保存原规则及样本结果,发布后再测同一组路径。不要只验证那条刚修好的产品页,还应检查其他公开内容是否被新规则误伤,尤其是共享前缀与语言目录。
相同路径换一个爬虫就不同,正常吗?
可能因为它们适用不同规则组。应看各自命中行和完整分组,再判断这是否符合既定公开策略,而不是要求所有身份必然同结果。
显示允许,页面却403,先改robots吗?
不一定。HTTP防护与规则许可是两层,应查实际访问和日志。修改robots不会自动解除服务器拒绝,应沿具体证据处理。
个人微信:ssevening


