
robots.txt只有几行,却可能影响整个网站的抓取入口。最危险的错误通常不复杂:想限制后台,误把根路径填进禁止项;新站上线时,又把测试环境的全站限制留在正式站点。生成之前,先列清楚哪些内容应该公开。
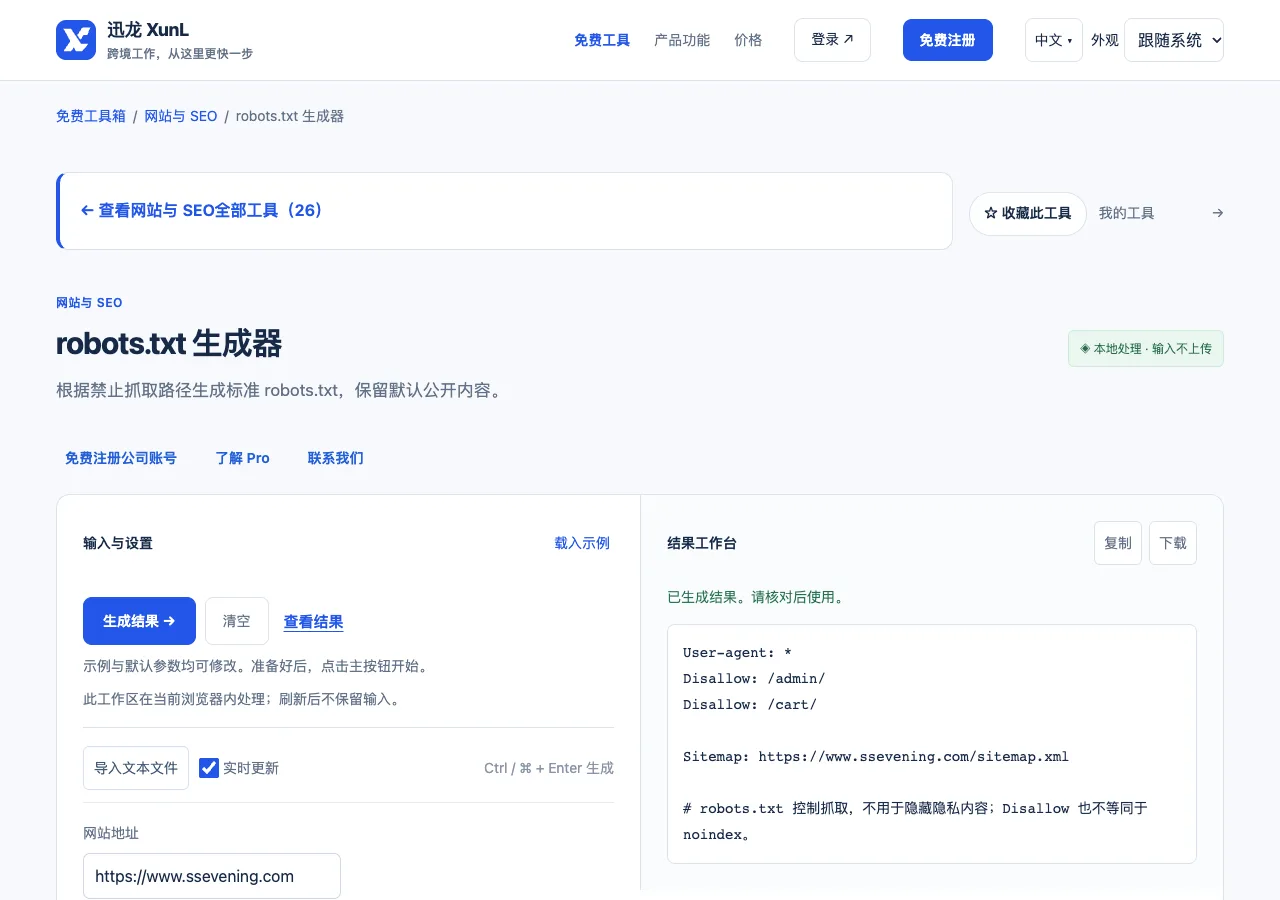
把“禁止什么”写成真实路径
XunL robots.txt生成器根据网站地址和逐行禁止路径整理文本。可用 https://www.example.com 演示网站地址,禁止项写成 /admin/ 与 /cart/,但部署时必须改为自己网站实际使用的目录。
路径不是完整业务说明。管理员应先确认后台、购物车和其他目录的位置,产品与文章是否落在同一前缀下。不能只因为一个目录名看起来像后台,就复制到生产文件,更不能为了省事把整个站点设为禁止。
空项与根路径,含义相差很大
生成器使用通用User-agent组与逐行Disallow。空的禁止值表示该组不新增对应限制;根路径则可能覆盖整站。检查结果时,把单独一个斜杠作为重点核查项,确认它是否真是预期。
如果旧文件已有针对特定爬虫的组,不能只看新生成的几行就整体替换。应先理解原规则用途和适用身份,再制定合并方案。规则数量少不代表正确,保留历史限制也不一定合理,关键是每组都有明确目标。
Sitemap行同样需要核实。假设站点实际使用/wp-sitemap.xml,就不能照搬/sitemap.xml示例。文件路径必须真实公开可取,否则只是提供一个无效线索。地图也应列出当前规范内容,而不是旧迁移清单。
部署前准备两组验证样本
第一组是必须公开抓取的样本,例如首页、一篇产品详情和一篇教程;第二组是按策略限制抓取的目录样本。先用规则检测工具判断,再将文件放到正式根目录。发布后直接访问正式robots地址,检查HTTP状态与实际正文是否正确。
这样做能发现文本本身正确、部署位置却错误的情况,也能避免缓存继续提供旧版本。保存原文件与修改时间,出现问题时可以明确回滚,而不是临时重新拼一份规则。
抓取建议不能代替安全和索引策略
路径要留意实际大小写与目录结构,例如产品目录和下载目录是否共用前缀。匹配范围过宽时,可能连公开说明书也一起限制。先列代表地址逐条核查,比只检查规则文字有没有拼错更可靠。
robots是公开文件,写入其中的路径对任何人都可能可见,不适合放秘密地址。后台、订单和会员资料应使用登录与权限控制,不能靠“不让爬虫抓”保护。拒绝某类爬虫也不等于所有访问者都会遵守。
如果目标是不让某个公开页面进入搜索结果,应按搜索平台的索引规则处理。单纯禁止抓取,可能使爬虫无法读取页面里的不索引指令,网址仍可能从外链被发现。先分清目标是减少抓取还是限制展示,再选正确方法。
可以先全站禁止,等收录稳定后再放开吗?
正式公开内容通常需要可被获取,是否限制应围绕实际发布策略。测试期和生产期要明确区分,切换环境时专门核查规则,不能把等待收录与禁止读取混为一谈。
改完robots,搜索结果会立即变化吗?
文件更新不代表平台马上重新抓取或处理索引。应保留部署证据并观察后续行为,不能以一次文件读回替代真实抓取与展示验证。
个人微信:ssevening


